
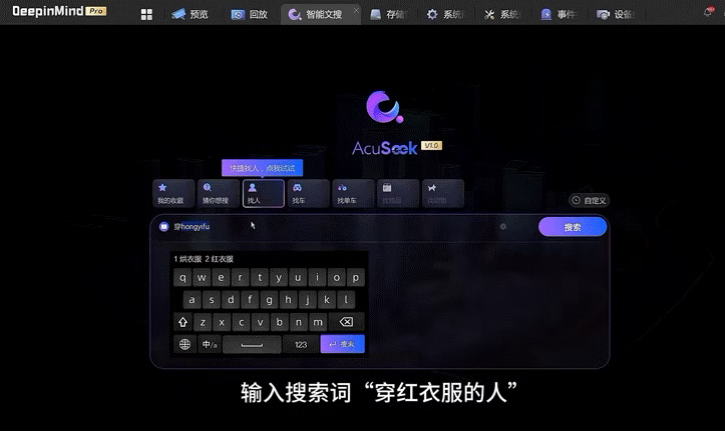
在日常搜索场景中,很多目标都没有专属标签和事件记录,比如遗失的黑色背包、白色雨伞、特定款式衣物等,传统搜索方式根本无法识别捕捉。而文搜可以通过简单的文字指令,输入“黑色背包”“穿黄色上衣的人”等具象描述,系统便会智能解析文本语义,遍历所有录像画面,快速筛选出包含对应特征的所有片段。这一步的核心作用是缩小搜索范围、过滤无效画面,从海量录像数据中,捞出含有目标特征的有效内容,解决了传统搜索“不会搜、搜不到、找不到”的核心痛点。
经过文搜完成大范围初筛后,图搜的核心价值,就是承接初筛结果,解决“找得到、追得准”的核心问题。以图搜图,依托精准的图像特征比对能力,精准锁定专属目标,复现目标活动动向。

简单来说,从文搜筛选出的画面中锁定目标,再以图搜图,汇总该目标出现的所有画面片段。按照时间顺序或者地图点位顺序进行梳理,能够还原目标的动向,精准定位目标最后出现的时间与位置,直接为找回物品、核查线索提供关键依据,真正实现从“搜到目标画面”到“找回目标对象”的关键跨越。
文搜+图搜的联动搜索逻辑,在复杂排查场景中优势极为显著。
举个例子:常规搜索手段极度依赖衣物、配饰等外观特征,一旦目标刻意改变外在样貌,就极易出现线索中断、目标跟丢的情况。而文搜+图搜联动模式不受表面外观变化影响,溯源追踪能力更加稳定、可靠。
在实际排查中,即便目标人员中途换装、更换衣帽等外在服饰样貌,系统依旧可以通过图搜精准抓取人脸等固有专属特征,锁定目标完整动向。哪怕是人员刻意伪装、更换穿搭的复杂场景,也能轻松完成动向溯源、锁定最后出现位置,大大降低排查难度。

 冀公网安备13010402002588